📋 요약 한 줄 요약 두 벡터의 길이를 각각 1로 맞춘 뒤 내적하면, 길이 차이의 영향을 없애고 방향이 얼마나 비슷한지 비교할 수 있다. 이 값이 코사인 유사도이며, 사용자 취향과 콘텐츠 특징을 비교하는 추천 점수로 활용할 수 있다.
이전 글 벡터의 내적과 추천 점수에서는 같은 자리끼리 곱해 더하는 내적으로 추천 점수를 계산했다. 그런데 두 글의 주제 비율이 같아도 내적 점수는 달라질 수 있다.
숫자 순서를 [Java, AI]로 두고, 사용자 관심도 [3,4]와 두 글의 주제 점수를 비교해보자.
| 글의 주제 점수 | 사용자와의 내적 | 코사인 유사도 |
|---|---|---|
A [6,8] | 3*6 + 4*8 = 50 | 1 |
E [9,12] | 3*9 + 4*12 = 75 | 1 |
A와 E는 Java와 AI의 비율이 같아 같은 방향을 가리키지만, 내적은 E가 더 높다. 벡터의 길이가 점수에 영향을 주기 때문이다. 길이의 영향을 없애고 방향이 얼마나 비슷한지 비교할 때 정규화와 코사인 유사도를 사용한다.
1. 정규화는 방향을 유지하면서 길이를 1로 맞춘다
여기서 다루는 정규화(Normalization)는 벡터의 각 값을 그 벡터 자신의 길이로 나누는 것이다. 방향은 유지되고 길이는 1이 된다.
숫자가 두 개인 벡터 [x,y]의 정규화 공식은 다음과 같다.
두 값 모두 같은 벡터 길이로 나눈다. 길이가 0보다 큰 벡터에 적용할 수 있다.
[6,8]의 길이부터 구한다.
각 값을 길이 10으로 나누면:
정규화한 벡터의 길이를 다시 계산해보면 정확히 1이다.
벡터 전체의 길이를 1로 맞춘다. 각 숫자가 모두 1이 되는 것은 아니다. 예를 들어 [100,0]을 정규화하면 [1,0]이 된다.
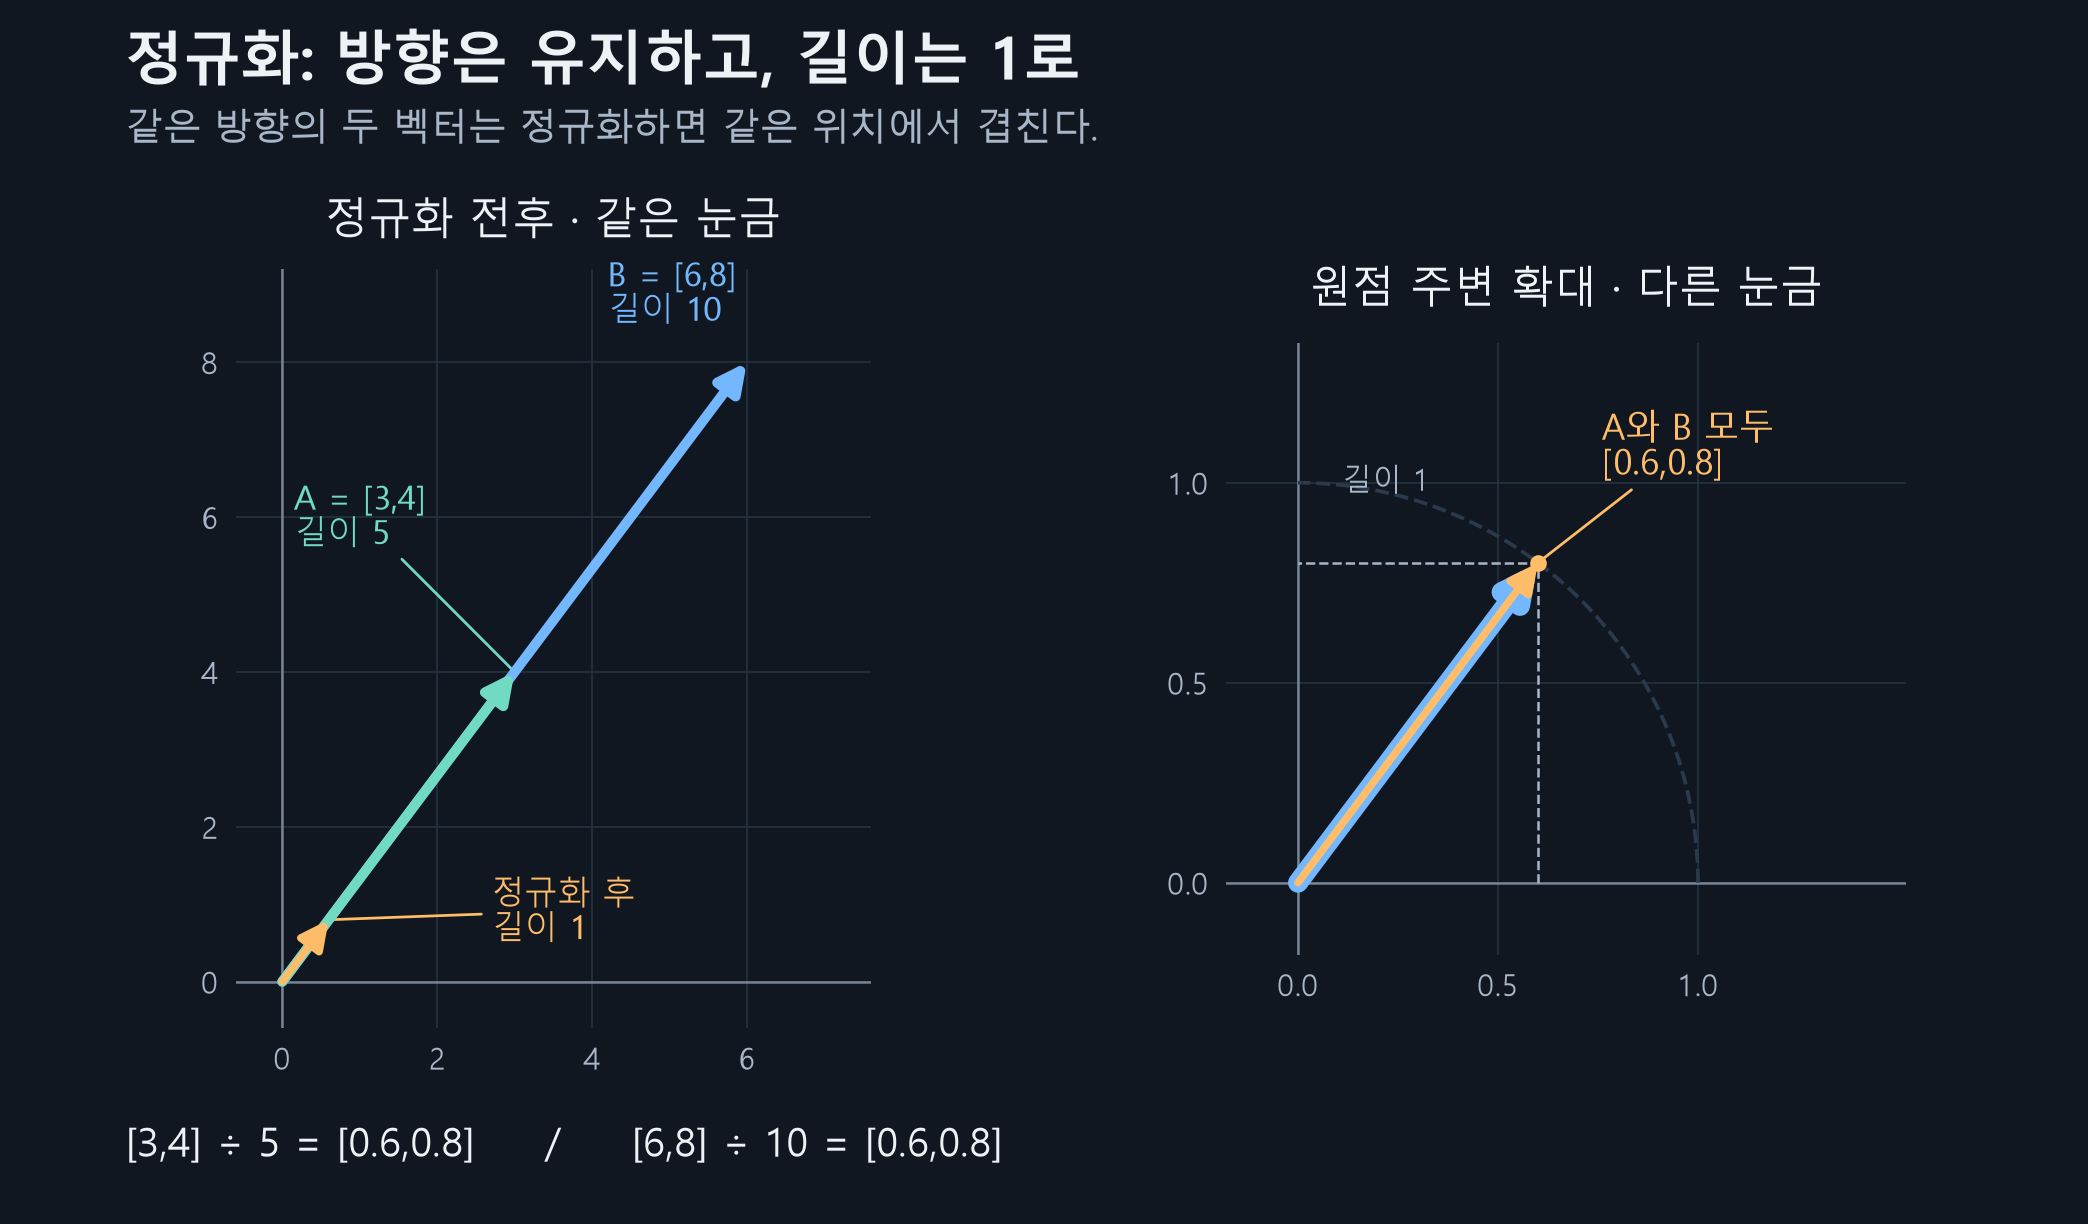
왼쪽은 정규화 전후를 같은 눈금으로 비교한 그림이고, 오른쪽은 길이가 1인 벡터가 잘 보이도록 원점 주변을 확대한 그림이다. 두 패널의 눈금 범위는 다르다.
[3,4]와 [6,8]은 같은 방향을 가리킨다. 각각 길이 5와 10으로 나누면 둘 다 [0.6,0.8]이 된다. 그림에서 두 화살표가 겹치는 이유도 이 때문이다.
길이가 0인 [0,0]은 나눌 길이가 없으므로 이 방식으로 정규화할 수 없다.
2. 길이를 똑같이 맞추는 이유
앞의 글 E [9,12]는 A [6,8]보다 벡터가 1.5배 길어서 내적도 1.5배였다. 두 글의 방향이 얼마나 비슷한지 비교하려면 이 길이 차이의 영향을 없애야 한다.
사용자 [3,4], 글 A [6,8], 글 E [9,12]를 각각 자기 길이인 5, 10, 15로 나누면 모두 [0.6,0.8]이 된다. 정규화한 사용자 벡터와 어느 글을 내적해도 결과는 1이다.
공통 길이로 1을 사용하면 계산도 간단해진다. 길이가 1인 두 벡터의 내적을 그대로 방향의 유사도 점수로 사용할 수 있기 때문이다.
3. 정규화한 두 벡터의 내적이 코사인 유사도다
코사인 유사도(Cosine Similarity)는 두 벡터가 이루는 각도를 바탕으로 방향의 유사성을 나타낸 값이다. 두 벡터를 각각 정규화한 다음 내적해서 구할 수 있다.
각 벡터의 길이 구하기
→ 각각 자기 길이로 나누기
→ 정규화한 두 벡터를 내적하기
두 벡터의 시작점을 같은 곳에 놓았을 때, 화살표 사이에 생기는 각도를 생각하면 된다. 결과는 각도 몇 도인지가 아니라 -1부터 1 사이의 유사도 값이다.
| 두 벡터 사이 각도 | 코사인 유사도 | 방향 관계 |
|---|---|---|
| 0° | 1 | 같은 방향 |
| 90° | 0 | 서로 직각 |
| 180° | -1 | 정반대 방향 |
다섯 방향을 같은 기준으로 비교하기
기준 벡터는 오른쪽을 가리키는 [1,0]이다. 아래 다섯 벡터도 모두 길이가 1이므로, 바로 내적하면 코사인 유사도가 된다.
| 벡터 | 방향 | 내적 계산 | 코사인 유사도 |
|---|---|---|---|
A = [1,0] | 오른쪽 | 1*1 + 0*0 | 1 |
B = [0.8,0.6] | 오른쪽 위, 가로 비중이 큼 | 1*0.8 + 0*0.6 | 0.8 |
C = [0.6,0.8] | 오른쪽 위, 세로 비중이 큼 | 1*0.6 + 0*0.8 | 0.6 |
D = [0,1] | 위쪽 | 1*0 + 0*1 | 0 |
E = [-1,0] | 왼쪽 | 1*(-1) + 0*0 | -1 |
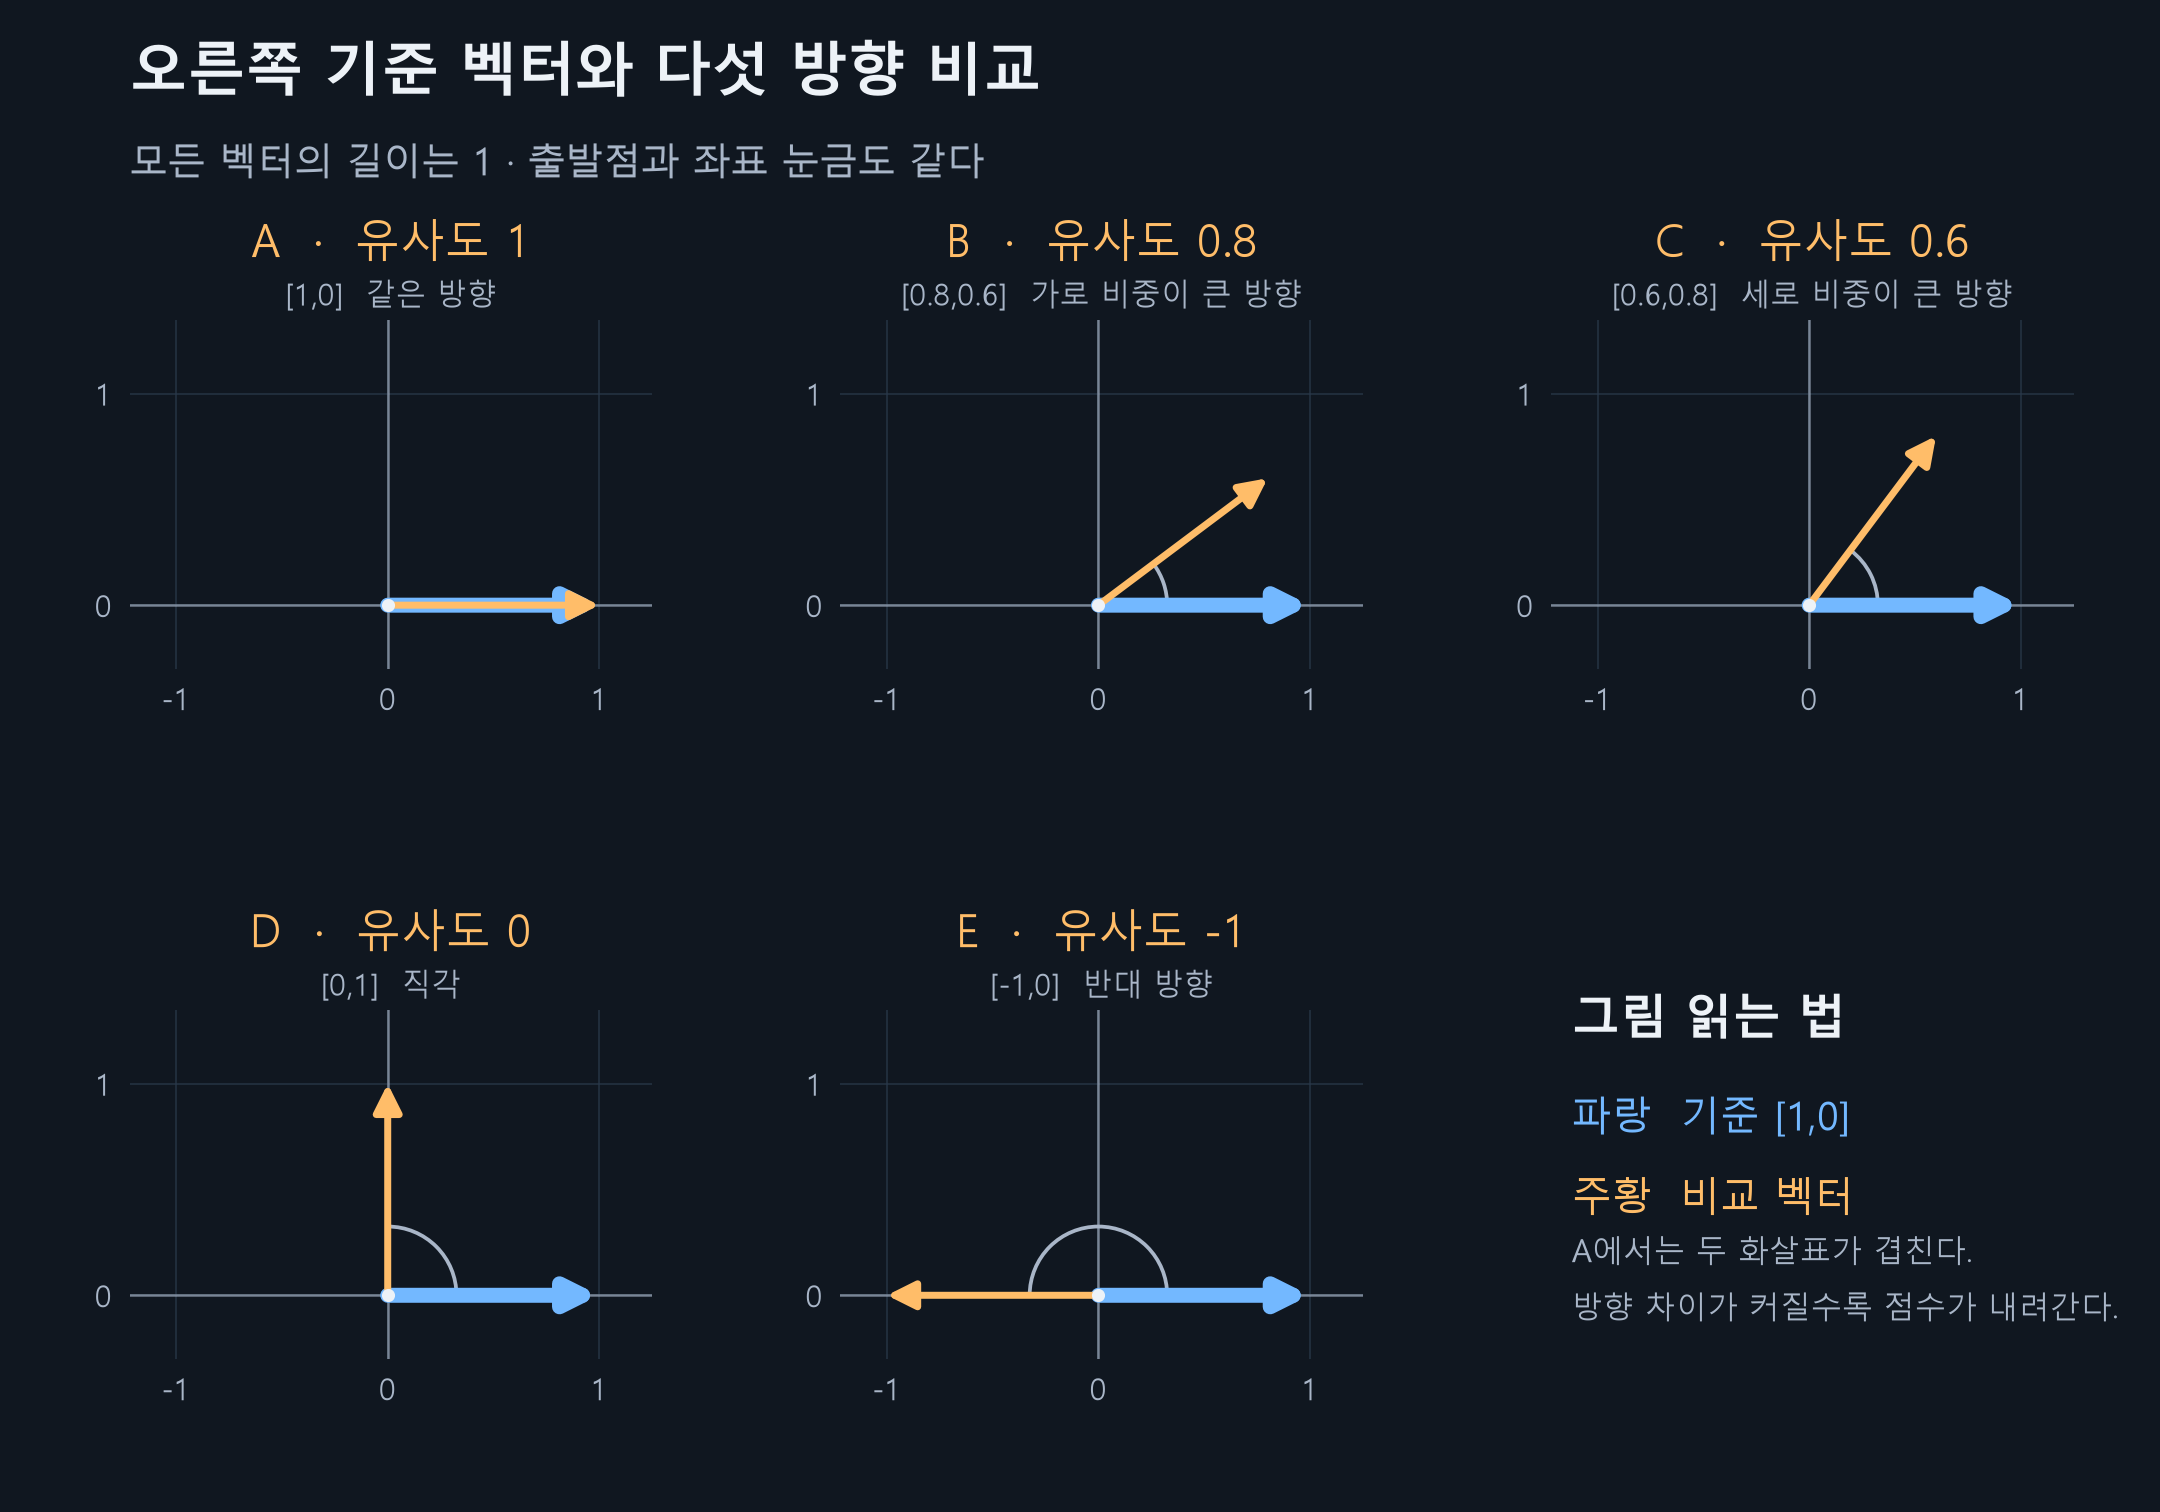
모든 패널은 같은 눈금과 같은 화살표 길이를 사용한다. A에서는 두 화살표가 겹치고, D에서는 직각, E에서는 반대 방향이 된다.
B와 C는 모두 오른쪽 위를 향하지만, 오른쪽 기준 벡터와 이루는 각도는 B가 더 작다. 따라서 B의 유사도 0.8이 C의 0.6보다 높다.
각도에 따른 점수를 그래프로 보기
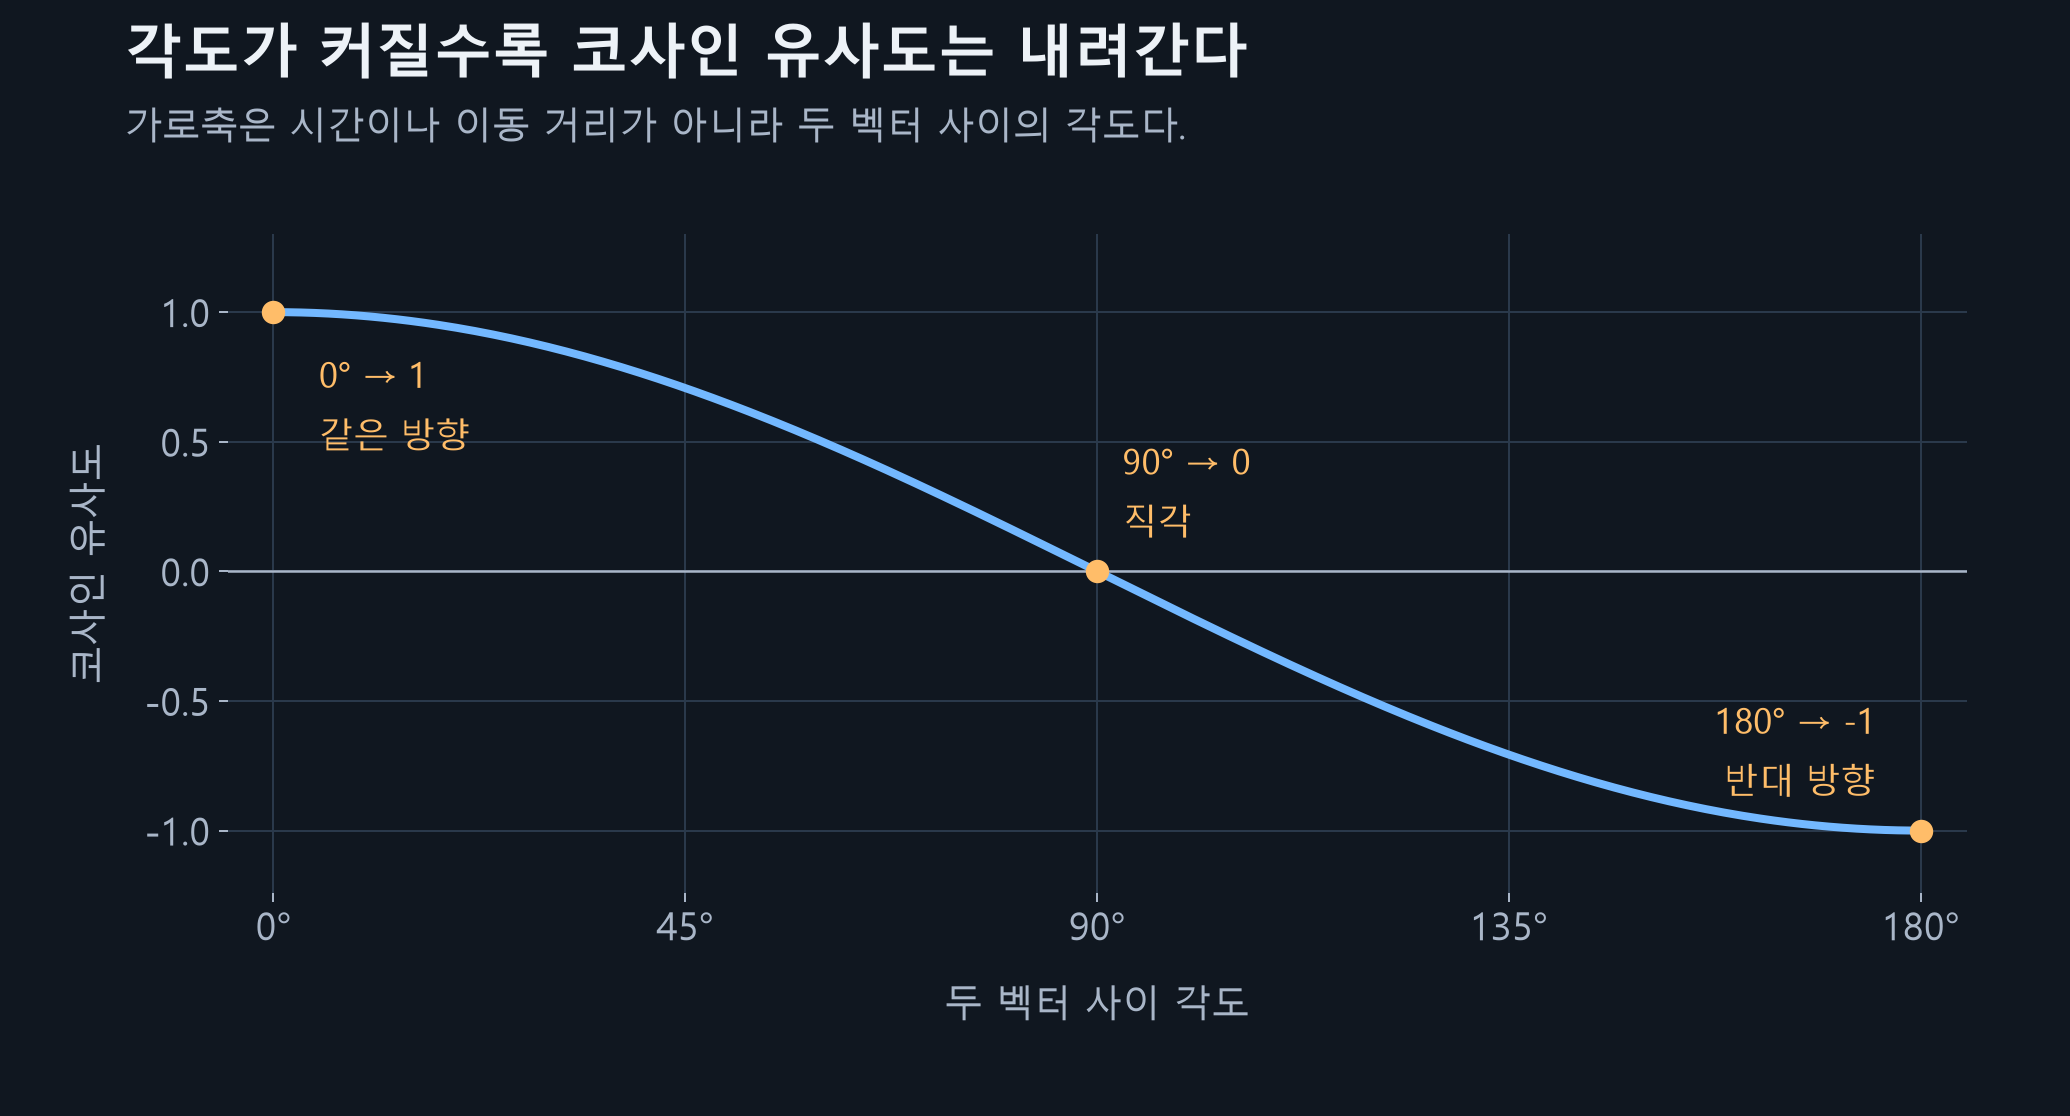
각도가 0°에서 180°로 커질수록 코사인 유사도는 1에서 -1로 내려간다. 1에 가까울수록 방향이 비슷하고, -1에 가까울수록 반대 방향에 가깝다.
직선의 교차와 앞으로 이동하는 경로
앞의 방향 비교 그림처럼 시작점을 원점에 맞추면, 원점이 이미 두 화살표가 만나는 점이다. 방향이 다른 두 화살표를 앞으로 계속 늘려도 원점 외에 새로운 교차점이 생기지는 않는다.
2차원에서 코사인 유사도가 0보다 크고 1보다 작은 두 방향은 평행하지 않다. 그 방향의 직선을 양쪽으로 끝없이 늘리면 한 점에서 교차한다.
다만 화살표 방향으로만 앞으로 진행하는 경로는 구분해야 한다. 출발 위치에 따라 교차점이 앞쪽에 있을 수도, 뒤쪽 연장선에 있을 수도 있다.
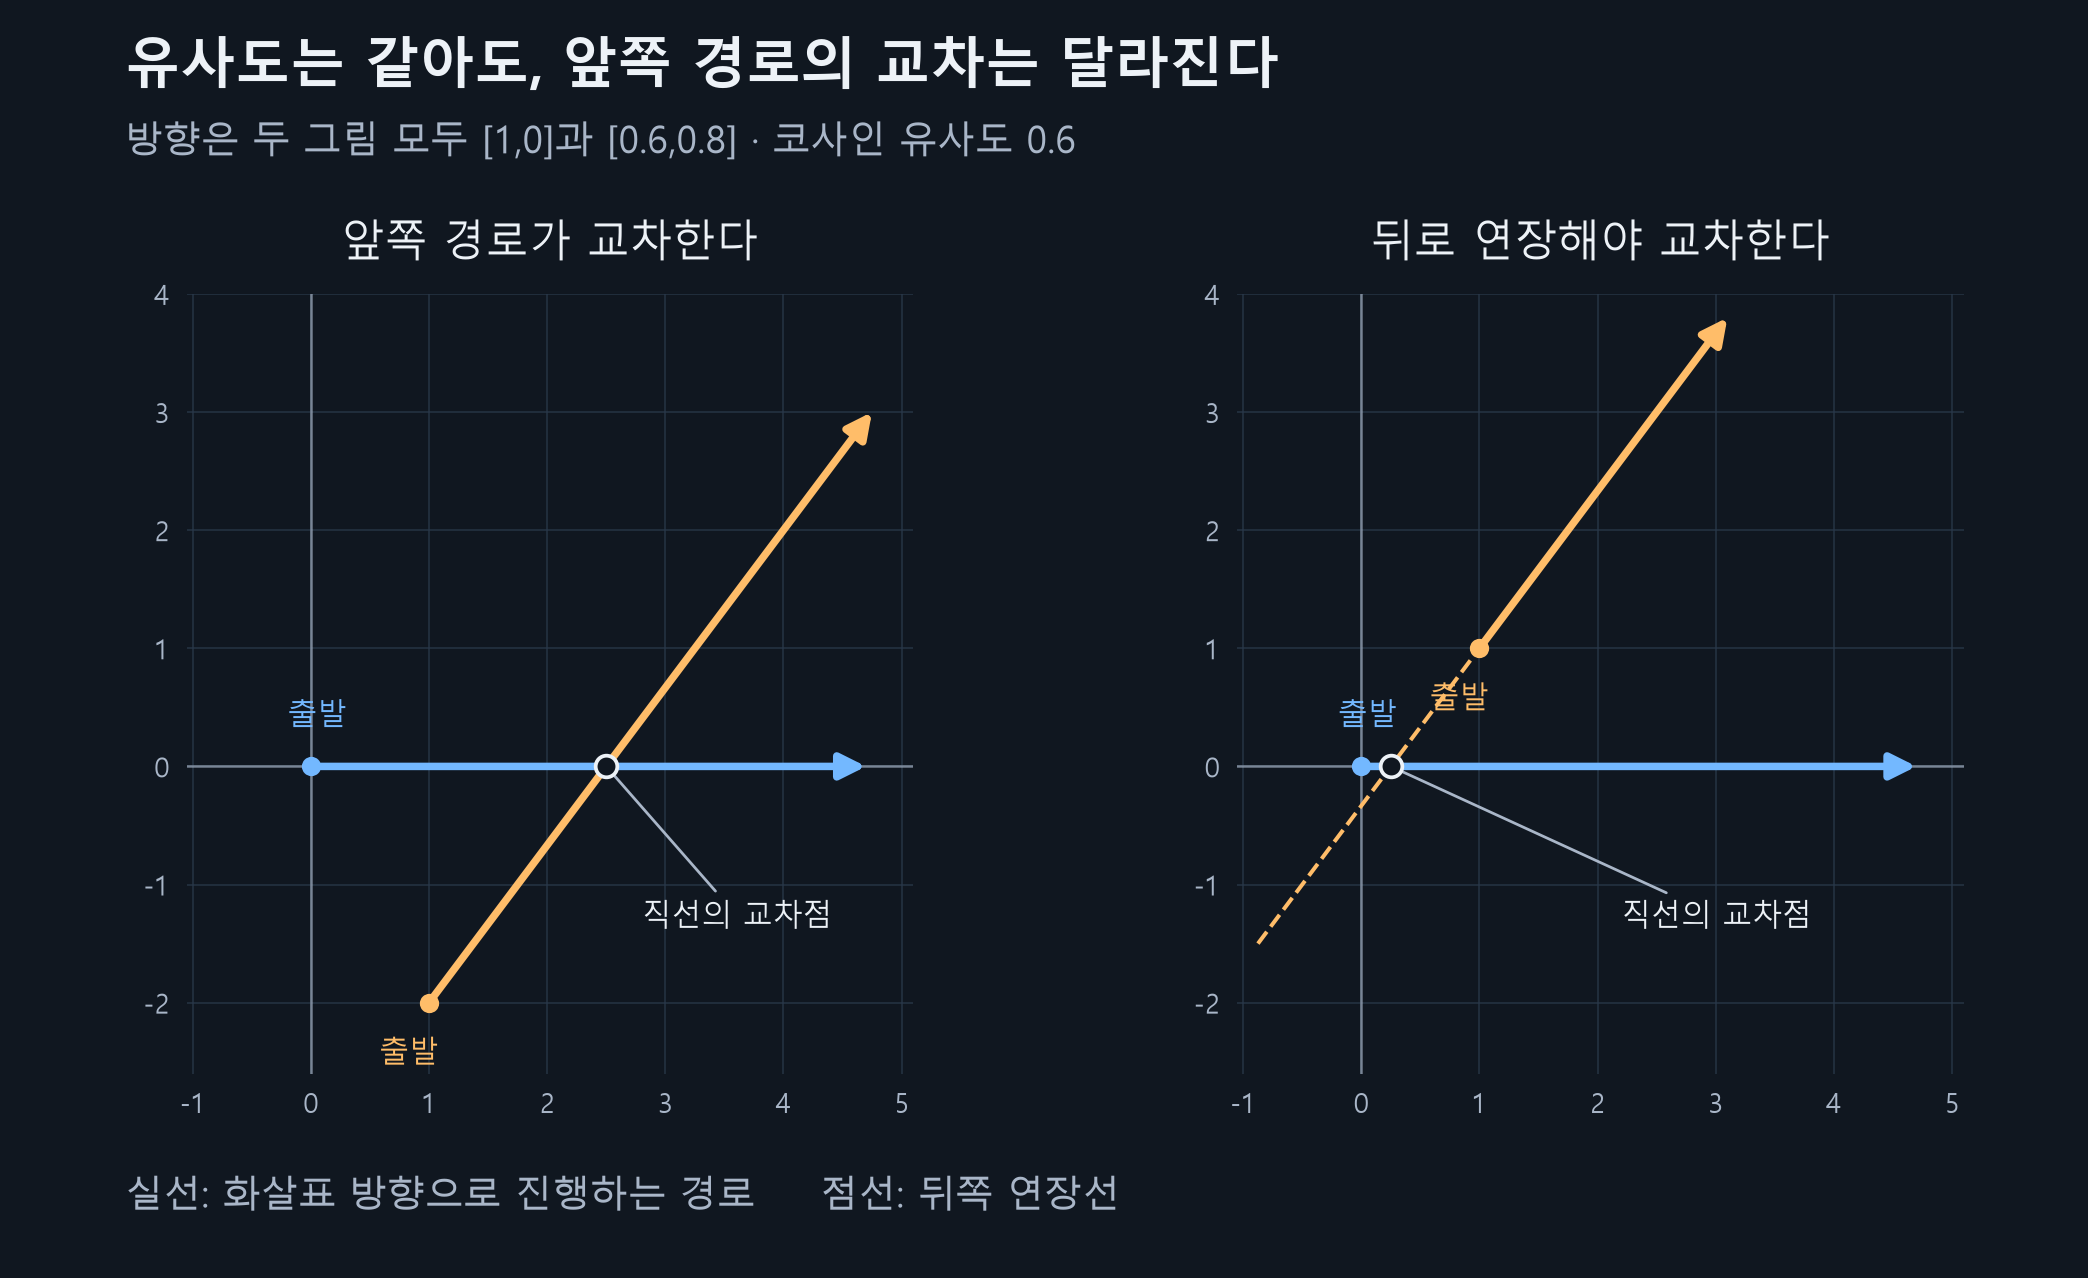
두 그림의 방향은 [1,0]과 [0.6,0.8]로 같고, 코사인 유사도도 모두 0.6이다. 달라진 것은 출발 위치다. 실선은 앞으로 진행하는 경로, 점선은 뒤쪽 연장선이다.
코사인 유사도에는 출발 위치가 들어 있지 않다. 따라서 값이 같아도 앞으로 이동하면서 경로가 만나는지는 달라질 수 있다. 두 물체가 실제로 만나는 상황이라면, 교차점에 같은 시간에 도착하는지도 따로 확인해야 한다.
4. 추천 글 예시
개발 글 추천 서비스를 가정한다. 모든 벡터의 숫자 순서는 [Java, AI]이고, 사용자 관심도는 [3,4]이다. 아래 주제 점수는 원리를 설명하기 위해 직접 정한 예시 값이다.
사용자 벡터의 길이는 5이므로 정규화하면 [0.6,0.8]이다.
| 글 | 제목 | 주제 점수 |
|---|---|---|
| A | Java로 AI 기능 연결하기 | [6,8] |
| B | Java 중심의 AI 서비스 구현 | [8,6] |
| C | AI 모델 기초 | [0,5] |
| D | Java 문법 정리 | [5,0] |
| E | Java와 AI를 함께 활용하기 | [9,12] |
각 글의 벡터도 자기 길이로 나눈 뒤, 정규화한 사용자 벡터와 내적한다.
| 글 | 원래 길이 | 정규화한 벡터 | 사용자와의 내적 | 유사도 |
|---|---|---|---|---|
| A | 10 | [0.6,0.8] | 0.6*0.6 + 0.8*0.8 | 1 |
| B | 10 | [0.8,0.6] | 0.6*0.8 + 0.8*0.6 | 0.96 |
| C | 5 | [0,1] | 0.6*0 + 0.8*1 | 0.8 |
| D | 5 | [1,0] | 0.6*1 + 0.8*0 | 0.6 |
| E | 15 | [0.6,0.8] | 0.6*0.6 + 0.8*0.8 | 1 |
예를 들어 글 B는 다음과 같이 계산한다.
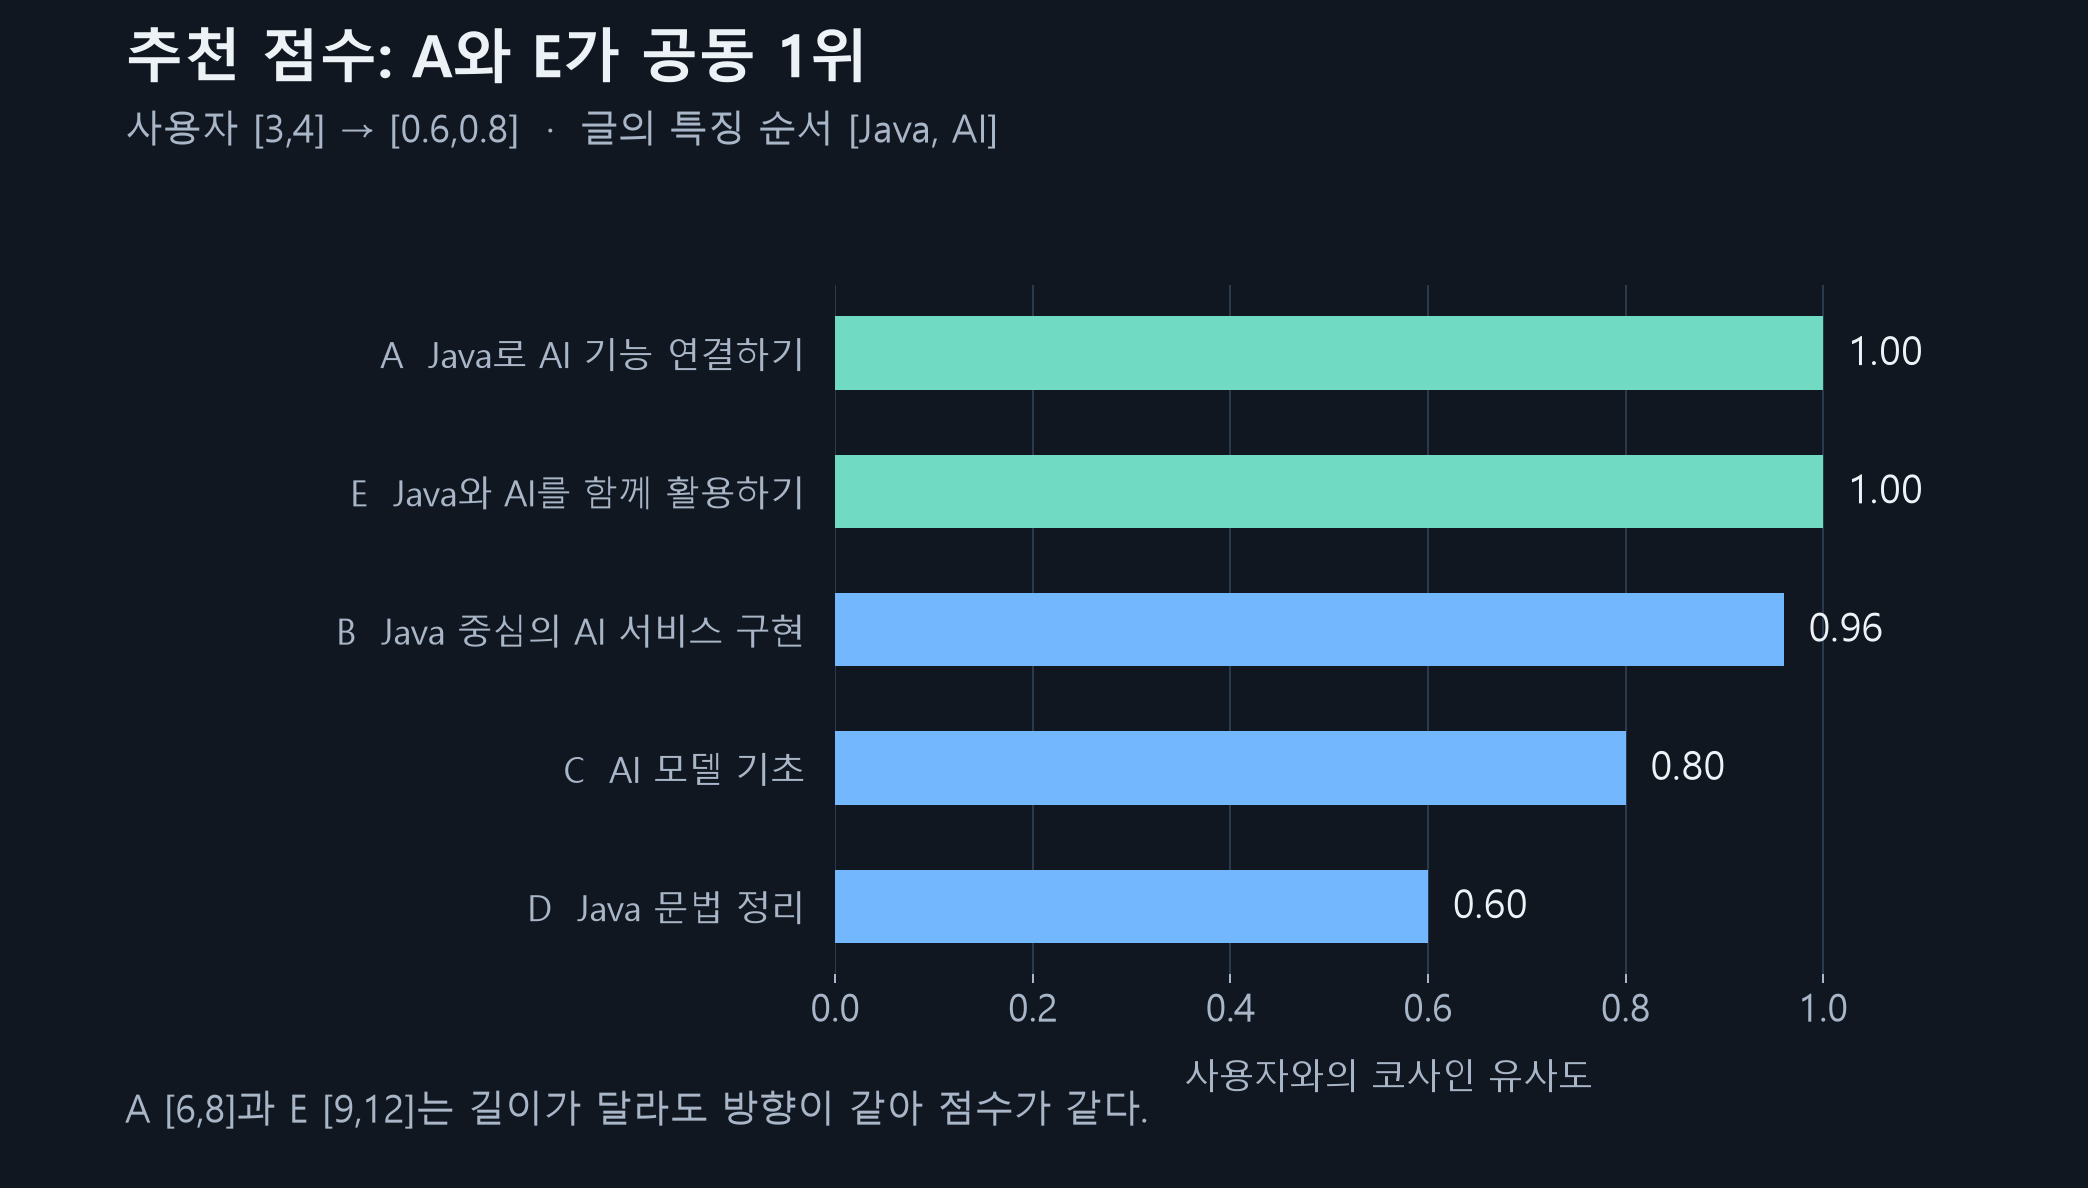
유사도가 높은 순서는 A와 E 공동 1위 → B → C → D이다. 이 점수만으로는 A와 E 사이의 우선순위를 정할 수 없다.
E는 A보다 원래 벡터의 길이가 크지만, 두 벡터의 주제 비율과 방향은 같다. 그래서 코사인 유사도도 똑같이 1이다. 활동량이나 점수의 크기보다 관심 비율이 비슷한지를 비교하고 싶을 때 정규화가 유용한 이유다.
방향 비교 예시의 B와 C는 오른쪽 [1,0]을 기준으로 비교했다. 이 추천 예시에서는 사용자 [0.6,0.8]이 기준이다. 유사도는 어떤 벡터와 비교하는지에 따라 달라진다.
5. Kotlin으로 추천 점수 계산하기
함수 안에서 길이 계산 → 정규화 → 내적을 순서대로 수행한다. 각 단계의 값을 변수에 담아 앞에서 배운 계산과 연결했다.
import java.util.Locale
import kotlin.math.sqrt

class Article(val title: String, val x: Double, val y: Double)

fun cosineSimilarity(
    aX: Double, aY: Double,
    bX: Double, bY: Double
): Double {
    // 1. 각 벡터의 길이를 구한다.
    val aLength = sqrt(aX * aX + aY * aY)
    val bLength = sqrt(bX * bX + bY * bY)

    if (aLength == 0.0 || bLength == 0.0) {
        throw IllegalArgumentException("길이가 0인 벡터는 비교할 수 없습니다.")
    }

    // 2. 각 값을 자기 벡터의 길이로 나눈다.
    val normalizedAX = aX / aLength
    val normalizedAY = aY / aLength
    val normalizedBX = bX / bLength
    val normalizedBY = bY / bLength

    // 3. 같은 자리끼리 곱한 뒤 더한다.
    val similarity = normalizedAX * normalizedBX +
        normalizedAY * normalizedBY

    return similarity
}

fun main() {
    val userJavaInterest = 3.0
    val userAiInterest = 4.0

    val articles = arrayOf(
        Article("A. Java로 AI 기능 연결하기", 6.0, 8.0),
        Article("B. Java 중심의 AI 서비스 구현", 8.0, 6.0),
        Article("C. AI 모델 기초", 0.0, 5.0),
        Article("D. Java 문법 정리", 5.0, 0.0),
        Article("E. Java와 AI를 함께 활용하기", 9.0, 12.0)
    )

    for (article in articles) {
        val score = cosineSimilarity(userJavaInterest, userAiInterest, article.x, article.y)
        System.out.printf(Locale.ROOT, "%s: %.2f%n", article.title, score)
    }
}
출력:
A. Java로 AI 기능 연결하기: 1.00
B. Java 중심의 AI 서비스 구현: 0.96
C. AI 모델 기초: 0.80
D. Java 문법 정리: 0.60
E. Java와 AI를 함께 활용하기: 1.00
반복문은 글을 A부터 E까지 입력한 순서대로 출력한다. 점수를 비교하면 추천 순서는 A와 E 공동 1위 → B → C → D이다. 소수점 두 자리 표시는 출력을 읽기 위한 형식이다.
참고 자료
- Unity 공식 문서 — Vector3.Normalize: 방향을 유지하면서 벡터의 길이를 1로 맞추는 연산.
- Unity 공식 문서 — Vector3.Dot: 내적과 벡터의 길이·각도 관계.